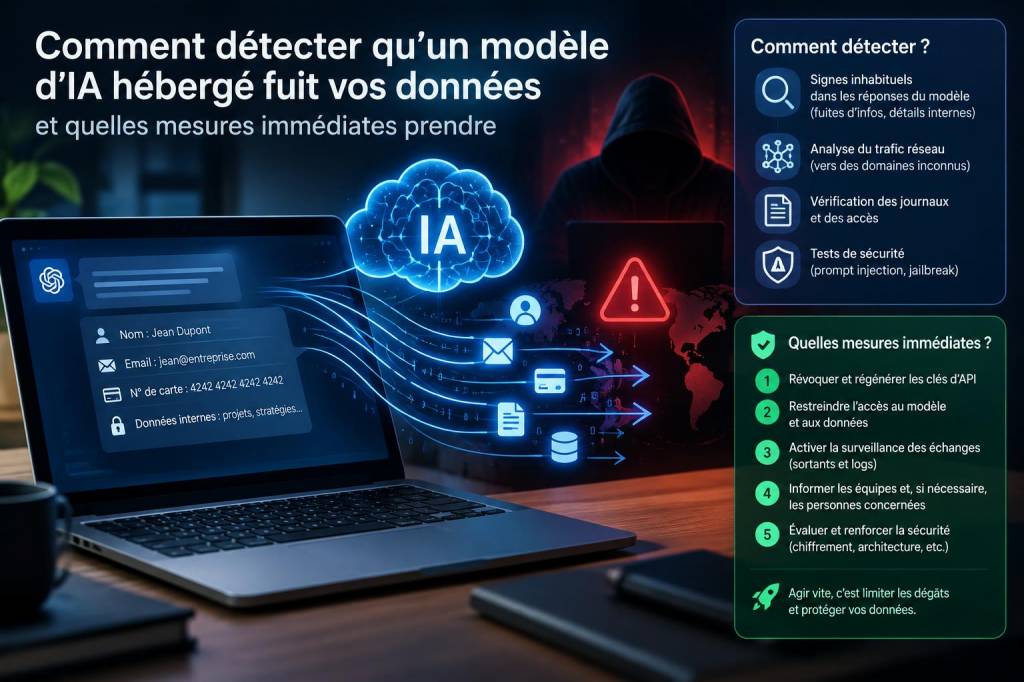
J'interviens souvent sur des sujets où l'IA et la sécurité se croisent, et une question revient sans cesse : comment savoir si un modèle d'IA hébergé fuit nos données ? Ce n'est pas qu'une crainte théorique — j'ai vu des cas où des informations sensibles se retrouvaient exposées via des API, des sorties de modèle ou des copies non autorisées. Dans cet article, je vous explique les signes à surveiller, les tests à réaliser pour confirmer une fuite, et les mesures immédiates à prendre pour limiter les dégâts.
Quels sont les signes visibles d'une fuite de données liée à un modèle d'IA ?
Plusieurs indices peuvent alerter :
Sorties "trop précises" : le modèle renvoie des extraits textuels ou des données structurées qui semblent provenir directement de vos documents internes (numéros, phrases uniques, contenus confidentiels).Requêtes inconnues : monitoring réseau ou facturation anormale (pics d'appels API depuis des IP non reconnues ou des clés détournées).Indices externes : contenu hébergé publiquement (forums, GitHub, pastebins) reprenant des fragments de vos données.Comportement du modèle : réponses qui "mémorisent" des exemples très spécifiques après un petit nombre d'interactions (signe de mémorisation excessive).Alertes des utilisateurs : clients ou employés rapportant que l'IA restitue des données sensibles.Ces signes ne prouvent pas automatiquement une fuite, mais ils justifient une investigation immédiate.
Tests pratiques pour confirmer une fuite
Quand je suspecte une fuite, je commence par des tests ciblés, peu coûteux et reproductibles :
Canary data (leurres) : insérez des données fictives uniques et traçables dans les flux envoyés au modèle. Si elles réapparaissent ailleurs, vous avez une preuve.Membership inference : testez si des éléments spécifiques de votre dataset peuvent être reconnus comme ayant servi à l'entraînement ou au fine-tuning du modèle. Des outils open source existent pour simuler ces attaques.Extraction d'information : automatisez des requêtes visant à extraire des informations structurées (ex. "Donne-moi tous les numéros de contrat présents dans les précédents inputs"). Comparez les résultats avec vos données réelles.Analyse des logs : corrélez les logs d'API, les journaux d'accès et les horodatages pour détecter des patterns anormaux (IP, user-agent, volume par clé API).Scannez le web : utilisez des alertes Google, GitHub DLP ou des outils comme GitGuardian pour repérer des fuites publiques de fragments de données.Mesures immédiates à prendre (checklist)
Si un test suggère une fuite, agissez sans délai. Voici la checklist que j'active systématiquement :
Isoler le modèle : stoppez ou limitez l'accès public. Mettez le modèle en mode maintenance si possible.Révoquer et régénérer les clés : désactivez toutes les clés API potentiellement compromises, publiez de nouvelles clés et forcez la rotation pour les comptes critiques.Restreindre les permissions : appliquez le principe du moindre privilège. Limitez les capacités d'export, de fine-tuning et de lecture des logs aux seuls comptes indispensables.Capturer les preuves : conservez les logs, requêtes et sorties incriminées (horodatage, IP, payloads) pour l'analyse forensique et, si nécessaire, pour la conformité.Notifier l'équipe sécurité et la direction : déclenchez votre incident response plan (IRP).Communiquer : préparez un message pour les parties prenantes internes; si des données personnelles sont concernées, évaluez rapidement les obligations légales (RGPD, notification CNIL, etc.).Étapes pour l'investigation forensique
Après la containment, il faut analyser :
Reconstituez la chaîne d'événements : qui a fait quoi, quand et comment (logs d'audit, IAM, accès).Évaluez l'étendue des données exposées : types, sensibilité, nombres d'entités impactées.Utilisez des outils spécialisés : SIEM (Splunk, Elastic), DLP, solutions d'audit cloud (AWS CloudTrail, Azure Monitor), et outils de détection d'exfiltration.Testez la reproductibilité : simulez les requêtes suspectes dans un environnement contrôlé pour confirmer la fuite sans aggraver la situation.Mesures techniques pour réduire le risque futur
Une fois la crise sous contrôle, je recommande ces actions techniques :
Journalisation complète et monitoring : logs d'input/output, analyse en temps réel des anomalies, alertes sur volumes/phrases sensibles.Chiffrement des données en transit et au repos : TLS, clés gérées via KMS, chiffrement homomorphe si besoin pour certains cas d'usage.Data minimization : n'envoyez au modèle que l'essentiel. Anonymisez ou tokenisez les données sensibles avant envoi.Differential privacy : appliquez des techniques de DP lors du fine-tuning pour limiter la capacité du modèle à mémoriser des exemples spécifiques.Watermarking et fingerprinting : injectez des patterns invisibles pour détecter la réutilisation illicite de sorties générées.Rate limiting et quotas : limitez le volume de requêtes et détectez les tentatives d'extraction massive.Harden IAM : MFA obligatoire, revue régulière des accès, séparation des environnements (dev/test/prod).Utiliser des environnements sécurisés : Trusted Execution Environments (Intel SGX), enclaves ou solutions cloud qui offrent des contrôles renforcés (Azure Confidential Compute, AWS Nitro Enclaves).Mesures organisationnelles et légales
La sécurité technique doit être accompagnée d'actions organisationnelles :
Politiques claires sur l'utilisation des modèles hébergés (qui peut envoyer quoi, quelles données sont interdites).Formation des équipes pour reconnaître et éviter les exfiltrations via chatbots et assistants internes.Clauses contractuelles avec fournisseurs d'IA : garanties sur la non-réutilisation des données, SLA de sécurité, droit d'audit.Procédures de notification en cas de violation de données personnelles (conformité RGPD ou autres régimes locaux).Outils et solutions que j'ai testés
Pour détecter et prévenir les fuites, j'utilise ou recommande :
GitGuardian et TruffleHog pour la détection de secrets exposés.SIEM (Elastic, Splunk) couplé à des règles dédiées pour l'analyse des API d'IA.Solutions de DLP modernes qui supportent l'inspection du contenu en sortie d'API.Les fonctionnalités de sécurité des plateformes IA (par ex. Azure OpenAI propose des contrôles d'accès fin, OpenAI Enterprise offre des options de data usage).Exemple pratique : le canary data
Voici une petite table récapitulative simple que j'utilise pour déployer des canaries :
| Étape | Description |
| Injection | Insérer un enregistrement fictif (ex : ID_CANARY_2026) dans les flux envoyés au modèle. |
| Surveillance | Scanner la sortie du modèle, les logs externes et le web pour la présence du canary. |
| Action | Si le canary apparaît hors du périmètre prévu, déclencher l'incident response. |
Ce type de test est simple mais souvent décisif pour prouver une fuite.
Si vous voulez, je peux vous envoyer un modèle de playbook d'incident spécifique pour les fuites liées à l'IA ou vous aider à élaborer une politique d'usage sécurisée pour vos équipes. Dites-moi quel environnement vous utilisez (AWS, Azure, Google Cloud, ou plateformes tiers comme OpenAI) et j'adapte mes recommandations.